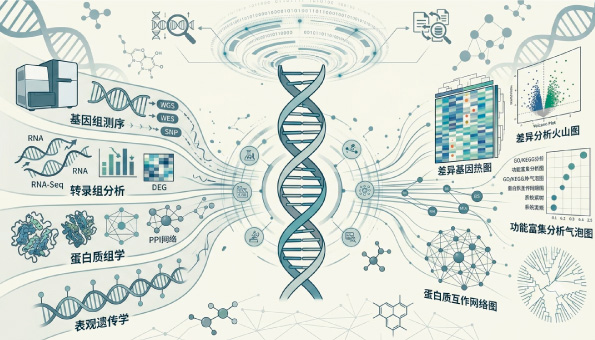
数据下载和准备
-作用和功能:从公共数据库(如 TCGA、GEO 等)获取原始的基因表达矩阵、临床随访数据及样本注释信息。这是整个生信分析的源头,目的是构建包含实验组与对照组(或肿瘤组与正常组)的原始数据结构。
-结果解读:检查样本的完整性、基因数量及行列匹配度,确保数据格式无误,为后续的量化和差异分析提供干净的原始输入。
数据标准化
-作用和功能:由于测序深度、批次效应或样本间技术误差的存在,原始表达量(如 Read Counts)无法直接比较。此步骤通过标准化或归一化算法(如 TPM、FPKM、VST 或 DESeq2 内置归一化),消除系统误差,使样本间的表达水平具备可比性。
-结果解读:标准化后的表达矩阵中,不同样本的表达值分布趋于一致(如箱线图呈现齐平状态),说明批次效应得到有效控制,可以进行后续的差异分析。
DESeq2 进行差异表达分析 (DEG)
-作用和功能:利用统计学模型(基于负二项分布的 DESeq2 算法)对两组样本的基因表达量进行显著性检验,计算出每个基因的表达变化倍数($\log_2\text{Fold Change}$)和显著性 $p$ 值(经多重假设检验校正后得到 $\text{padj}$)。
-结果解读:筛选出在两组之间存在统计学显著差异的基因。通常以 $\text{padj} < 0.05$ 且 $\vert{}\log_2\text{Fold Change}\vert{} > 1$ 为标准,划分为显著上调基因(Up-regulated)和显著下调基因(Down-regulated)。
绘制第一张核心图表——火山图 (Volcano Plot)
-作用和功能:将差异表达分析的结果通过二维散点图进行可视化。横坐标通常为 $\log_2\text{Fold Change}$(代表表达变化幅度),纵坐标为 $-\log_{10}(\text{padj})$(代表统计学显著性)。
-结果解读:图表两侧呈“火山喷发”状的散点代表核心差异基因。位于右上方的是显著上调基因,左上方的是显著下调基因,中间未达到阈值的点则为无显著差异的背景基因。
绘制表达热图 (Heatmap)
-作用和功能:通过聚类算法和颜色渐变矩阵,直观展示多样本间特定基因(通常是差异最显著的前几十个基因)的表达模式。
-结果解读:热图中的每一行代表一个基因,每一列代表一个样本。通过颜色深浅(如红高蓝低)可以看出样本在疾病组与对照组之间的聚类是否良好,以及核心基因在不同样本中的表达趋势是否具有高度的一致性。
基因标准名称转换
-作用和功能:由于基因ID存在多种形式(如 Ensembl ID、Entrez ID、Symbol 等),不同数据库之间的命名规范不统一,此步骤利用注释包将基因 ID 统一转换为标准的基因符号(Gene Symbol)。
-结果解读:确保后续的富集分析、数据库交叉验证及网络构建能够准确识别基因,避免因 ID 不匹配导致数据丢失。
GEO 独立队列交叉验证准备
-作用和功能:为了避免单一数据库(如 TCGA)的过拟合或假阳性结果,需要从 GEO 数据库下载独立的外部门诊或临床队列数据集,并进行数据清洗和预处理,作为验证集。
-结果解读:获得一个结构规范、与训练集具有可比性的独立临床表达矩阵,用于检验前期筛选出的差异基因是否具有普遍适用性。
TCGA 结果进行交叉验证 (取交集)
-作用和功能:将本地分析的候选差异基因与外部验证队列(如 GEO 数据集)或多维度数据进行比对,取交集(Venn Diagram)。
-结果解读:交集中的基因代表在不同队列、不同批次样本中均稳定表达异常的基因,极大地提高了后续研究的可靠性和生物学真实性。
常用富集分析(GO / KEGG)
-作用和功能:对筛选出的核心差异基因进行功能注释与通路富集分析。GO(Gene Ontology)分析其在生物过程、细胞组分和分子功能上的分布;KEGG(Kyoto Encyclopedia of Genes and Genomes)分析其参与的生物化学代谢通路或信号传导途径。
-结果解读:明确这批基因主要富集在哪些核心病理机制或分子通路上(例如肿瘤免疫逃逸通路、细胞周期调控等),从而从宏观上解释疾病发生发展的分子机制。
生存与预后分析
-作用和功能:结合样品的临床生存随访数据(如总生存期 OS、无进展生存期 PFS),利用 Kaplan-Meier 生存曲线和 Cox 比例风险回归模型,评估特定基因的高低表达对患者预后生存的影响。
-结果解读:若 $p < 0.05$,说明该基因或基因集与患者的生存显著相关(如高表达预示生存期缩短),可进一步评估其作为临床预后生物标志物(Biomarker)的潜力。
PPI 网络与核心基因筛选
-作用和功能:将目标基因导入 STRING 数据库构建蛋白质相互作用(Protein-Protein Interaction, PPI)网络,并利用 Cytoscape 软件及其拓扑算法(如 MCC、Degree 等)计算网络中的核心节点。
-结果解读:识别出在整个分子互作网络中处于枢纽地位的 Hub 基因(核心基因),这些基因往往是驱动特定生物学过程的关键调控因子。
扫码关注官方微信公众号

 6 次┆分享
 次
